

1. 서 론
2. 데이터 및 연구방법
2.1 분석 데이터
2.2 매설환경 속성정보 재구축 및 회귀분석 모델 개선
2.3 AI 기반 예측모델 개요
2.4 일치도 분석 방법론
3. 연구결과
3.1 매설환경 반영 개선모델의 성능
3.2 전체 열수송관 모집단 기준 AI-개선모델 순위 일치도
3.3 실제 파손사례 기준 3자 비교
3.4 이중검증 체계의 현장 적용 방안
4. 결 론
1. 서 론
지역난방시스템은 열병합발전소 등 대규모 열생산시설에서 생산된 열을 열수송관을 통해 다수의 수요자에게 공급하는 집단에너지 공급방식으로, 열수송관은 상하수도, 가스관 등 도심지 내 매설된 다른 배관과 함께 핵심적인 기반시설로 관리되고 있다. 그러나 매설된 지 20년 이상 경과한 장기사용 열수송관의 비율이 지속적으로 증가하면서 파손, 누수 사고에 대한 우려도 함께 커지고 있다. 이에 정부는 열수송관 안전진단 강화를 위한 종합대책을 수립하였으며(산업통상자원부, 2019), 2020년 집단에너지사업법(MOLEG, 2020) 개정을 통해 20년 이상 장기사용 열수송관에 대한 안전진단을 의무화하였다.
이러한 제도적 요구에 대응하기 위하여 열수송관의 파손 가능성을 사전에 예측하고 고위험 열수송관을 선별한 뒤 성능개선 사업을 진행할 시설물의 우선순위를 합리적으로 선정하기 위한 연구가 진행되고 있다. 국내 지역난방사업자들은 기존 유지관리 정보를 DB화하고 GIS 기반의 설비이력과 파손이력 데이터를 구축하고 있다. Kong and Kang(2021)는 유럽의 실증연구 사례와 국내 열수송관 관리기준을 검토하여 파손확률과 연관된 평가인자를 도출하고, 국내 사업자들과 협력하여 설비이력, 파손이력을 활용한 사용기간-파손확률 간 지수형 회귀모델을 제시하였다. 이와 함께 공급회수·관경-매설깊이·감시시스템 등 부가 변수에 대한 가중치를 통계적으로 산정하여 모델을 정교화하였다. 해당 연구에서 제시한 사용기간 중심의 접근법은 이중보온관의 전단강도 저하를 가속화하여 자연노화 시험으로 규명한 국외 연구(Vega, 2020)의 흐름과도 일치한다. 또한 Kong et al.(2024)는 데이터 고도화 및 모델 개선을 위해 열수송관 설비이력에 매설환경(도로·수계·기타) 속성정보를 GIS 기반 공간분석을 통해 추가하고, 매설환경별 파손경향을 분석하여 수계 매설환경의 파손빈도가 전체 평균 대비 8배 이상 높다는 상관관계를 실증하였다. 다만 해당 연구는 매설환경과 연계성을 가질 수 있는 사용기간 등 교란요인을 폭넓게 고려하지 않아 매설환경을 기존 회귀모델의 가중치로 반영하지는 않고 있다. 최근에는 기계학습(machine learning) 기법을 적용한 인공지능(AI) 기반 예측모델 연구도 함께 진행되고 있다. Lee et al.(2025)은 XGBoost(Chen&Guestrin, 2016), LightGBM(Ke et al., 2017) 앙상블 모델과 KNN 기반 재라벨링 기법을 적용하여 극심한 불균형 데이터(파손 비율 1 % 미만) 환경에서도 높은 예측 성능(F2-score 0.921, AUC 0.993)을 보고한 바 있다. 이는 동일 연구진이 도심지 지하시설물 속성정보를 활용한 지반침하 위험 예측에 기계학습을 적용한 선행연구(Lee et al., 2023)의 방법론적 연장선에 있다. 유럽 지역난방사업자들의 경우 파손확률과 파급효과를 결합한 위험도 매트릭스(risk matrix) 기반의 유지관리 의사결정을 주로 활용하고 있으며(Sernhed&Jönsson, 2017), 최근에는 AI를 활용한 예측 기반의 유지관리(predictive maintenance) 방안을 연구하고 있다(Rafati&Shaker, 2024). 그러나 사용기간 기반 회귀분석 모델과 AI 기반 모델은 개발 목적과 모델별로 적용된 변수의 종류, 모델의 구조가 상이하므로 두 종류의 모델을 현장에 적용하여 위험구간 예측 결과가 상충될 경우 어느 모델의 판단 결과를 우선 반영할지에 대한 정량적 근거가 부재한 상황이다. 따라서 각 모델을 동일한 지역난방 네트워크에 적용할 경우 얼마나 일치된 결과를 도출할 수 있는지에 대한 검증이 이루어져야 성능개선사업 예산 및 인력이 제한적인 지역난방사업자 입장에서 원활한 의사결정을 진행할 수 있다.
본 연구에서는 회귀분석 모델 개선 및 개선 전후 회귀분석 모델과 AI 예측모델간 일치도를 비교하였다. 먼저 열수송관 전체 설비이력(기본단위)과 매설환경 공간정보를 매칭하여 기본단위별 매설환경 속성을 재구축하고, 이를 사용기간 기반 회귀분석 모델에 추가 가중치로 반영한 개선모델을 제시하였다. 또한 실제 파손이력을 활용하여 개선 전후 회귀모델의 판별력을 정량적으로 검증하였다. 추가적으로, 개선 전후 회귀모델과 별도로 개발된 AI 기반 예측모델(XGBoost·LightGBM 앙상블)간 순위 일치도와 실제 파손사례에 대한 상대적 판별 성능을 비교·분석하고 두 모델의 장단점을 활용한 현장 활용방안을 제시하였다. 다만 AI 모델의 경우 회귀모델과의 비교 대상으로서 모델의 예측 결과값만 활용하였으며, 모델의 세부적인 구조와 하이퍼 파라미터는 Lee et al.(2025)을 따르고, 본 연구에서는 대리모델(surrogate model) 기반의 변수 기여도만 제시하였다.
2. 데이터 및 연구방법
2.1 분석 데이터
국내 지역난방사업자로부터 제공받은 열수송관 설비이력과 파손이력, 국토교통부에서 운영 중인 브이월드에서 확인 가능한 도로 및 수계 공간정보를 분석 데이터로 활용하였다. 또한 선행 연구를 통해 개발한 사용기간 기반 회귀모델과 AI 예측모델 상세 결과값을 모델간 비교·분석을 위해 수집하였다. 328,279건의 열수송관 설비이력(기본단위)는 관경, 용도, 매설깊이, 준공년도, 절연레벨, 감시시스템 정보 등 83개 속성정보를 포함하고 있다. 파손이력의 경우 열수송관 보수이력 4,383건 중 세부 속성정보를 통해 사전에 파손으로 확인된 2,310건을 본 연구에 활용하였으며, 손상원인, 강관상태, 보온재 상태, 발견일자 등 속성정보와 GIS 기반 위치정보(좌표)를 포함하고 있다. 다만, 파손이력 2,310건은 열수송관 감시시스템인 ‘루프’ 단위 4,308개 중 1,053개에 분포하며, 상위 10 %에 해당하는 루프(431개)에 확인된 파손의 70 %가 집중되어 있다. 또한 같은 루프에 포함되어 있는 열수송관 기본단위는 압력, 유속, 사용기간 등 속성정보가 유사하여 같은 루프 안에서 발생한 파손은 서로 독립적이라고 보기 어렵다. 따라서 모든 가중치의 95 % 신뢰구간은 같은 루프의 파손이 상호간 독립적이지 않는 것을 고려하여 루프 단위로 재추출하는 부트스트랩(2,000회)으로 산정하였다.
매설환경 분석을 위해 필요한 공간정보(폴리곤)는 브이월드를 통해 확보한 전국단위 도로 및 수계 폴리곤 레이어 중 열수송관이 매설되어 있는 지자체에 위치한 도로 428,120건과 수계 228,768건을 발췌하여 확보하였다. 모델간 성능비교를 위해 사용기간 기반 회귀모델을 통해 산출된 각 기본단위별 파손확률 추정값과 기술성, 경제성, 건전성 평가 등급 및 평가 점수도 활용하였다. AI 예측모델의 결과값은 회귀모델과 동일한 열수송관 모집단을 대상으로 별도 구축된 XGBoost·LightGBM 앙상블 모델의 각 기본단위별 위험확률을 활용하였다.
2.2 매설환경 속성정보 재구축 및 회귀분석 모델 개선
매설환경 범주는 사업자가 제공한 파손이력 내 점용위치 코드가 도로, 보도, 하천, 고수부지, 녹지 등으로 구성되어 있으며, 브이월드를 통해 도로, 수계 폴리곤 데이터를 확보 할 수 있는 측면을 고려하여 도로, 수계, 기타로 설정하였다. 각 기본단위별 매설환경 속성정보를 재구축하기 위해 열수송관 설비이력의 1차원 형상정보(폴리라인)와 도로·수계의 2차원 공간정보(폴리곤)간 중첩구간을 분석하였다. 도로 레이어의 경우 열수송관 설비이력과 동일한 KGD2002 중부원점 통합좌표계(Transverse Mercator)가 사용되고 있어 별도의 좌표변환 없이 GIS 분석툴을 활용하여 중첩구간을 확인하였다. 반면 수계 레이어의 경우 Web Mercator 좌표계(EPSG:3857)로 구축되어 있어 Transverse Mercator 역산식(Snyder, 1987)을 적용하여 좌표를 변환한 후 열수송관과의 중첩 여부를 확인하였다. 도로와 수계 공간정보에 동시에 중첩되는 열수송관은 교량 하부의 수계구간 하단에 위치하는 것이므로 수계로 매설환경을 구분하였다. 분석결과 전체 328,279건 중 도로는 214,908건(65.5 %), 수계는 3,148건(1.0 %), 기타는 110,223건(33.6 %)으로 나타났다.
포인트 형상정보로 구축되어 있는 열수송관 파손이력의 경우 기존 속성정보 내 ‘점용위치’ 속성코드와 파손이력의 GPS 좌표를 활용한 도로, 수계 공간정보와의 최근접 공간매칭 방법을 병행하여 매설환경 속성정보를 구축하였다. 다만, 파손이력의 GPS 좌표는 사업자가 시설물 파손 복구 시 GPS 좌표를 측정하여 기록된 것이 아니라 파손이력 내 서술되어 있는 주소정보 또는 근접 건물 정보로 추정하여 임의로 설정된 값이므로 본 연구에서는 ‘점용위치’ 속성코드를 우선 시 하고, 속성코드가 기재되지 않은 경우에만 GPS 좌표를 활용하였다. 점용위치 코드 중 도로(USE001)와 보도(USE002)는 도로, 하천·고수부지(USE005)는 수계로 정리하였으며, 녹지·단지 내 등 나머지 코드(USE003·004·006·000·010·999)는 기타로 구분하였다. 점용위치가 기재되지 않은 353건은 파손지점의 GPS 좌표를 기준으로 보완하였다. 그 결과 파손이력 2,310건은 도로 1,356건, 수계 206건, 기타 748건으로 구분되었다. 확보된 설비이력과 파손이력 내 매설환경 속성정보는 기존 회귀분석 모델 내 매설환경에 대한 가중치를 산정 시 활용하여 회귀분석 모델의 성능을 개선하였다.
또한 매설환경 가중치가 사용기간 등 기존 변수의 영향을 중복하여 반영하는지 확인하기 위해 준공년도를 구간별(~1995, 1996~2005, 2006~)로 나누어 층화 가중치와 기존 회귀모델의 기대 파손건수 대비 관측 파손건수의 비(잔차보정 가중치)를 함께 산정하였다.
2.3 AI 기반 예측모델 개요
사용기간 기반 회귀분석 모델과 성능비교 대상인 AI 예측모델은 회귀분석 모델과 동일한 설비이력과 파손이력을 입력자료로 사용하였으며, XGBoost(Chen&Guestrin, 2016)와 LightGBM(Ke et al., 2017)을 결합한 앙상블 구조로 구성되어 있다. 입력 변수로는 관경, 용도(공급/회수), 절연레벨, 사용기간, 매설환경(도로/수계/기타)의 5개 기본 변수와 매설환경과의 상호작용을 확인할 3개 복합변수(관경×매설환경, 용도×매설환경, 절연레벨×매설환경)를 활용하였다(Lee et al., 2025). 다만, 설비이력과 파손이력을 포함한 전체 데이터에서 파손이력이 차지하는 비율이 1 % 미만이므로, 데이터의 불균형 문제를 보완하기 위해 K-최근접이웃(KNN) 기반 재라벨링 기법을 적용하여 고위험군 후보를 먼저 선별한 후 모델을 학습하였다. 본 연구에서는 해당 모델에서 산출된 기본단위별 위험확률을 모델간 비교 분석에 활용하였다. 또한 AI 모델이 학습한 변수의 영향을 확인하기 위해, 기본단위별 위험확률(로짓 변환)을 입력 변수로 재현하는 대리모델(LightGBM)을 구축하고 SHAP(Lundberg&Lee, 2017) 기여도를 산정하였다.
AI 모델과 회귀분석 모델의 결과를 동일한 기본단위 기준으로 연결하기 위해 열수송관의 형상정보(폴리라인 좌표)를 이용한 최근접 공간매칭을 수행하였으며, 열수송관 기본단위별 고유식별자(BCUNT_SCTN)는 매칭 기준에서 제외하였다. 분석결과 양 모델에서 활용한 열수송관의 100 %가 0 m 거리에서 일치하여 두 데이터셋이 동일한 열수송관 모집단으로 구성되어 있어 두 모델간 일치도 비교가 가능한 것을 확인하였다.
2.4 일치도 분석 방법론
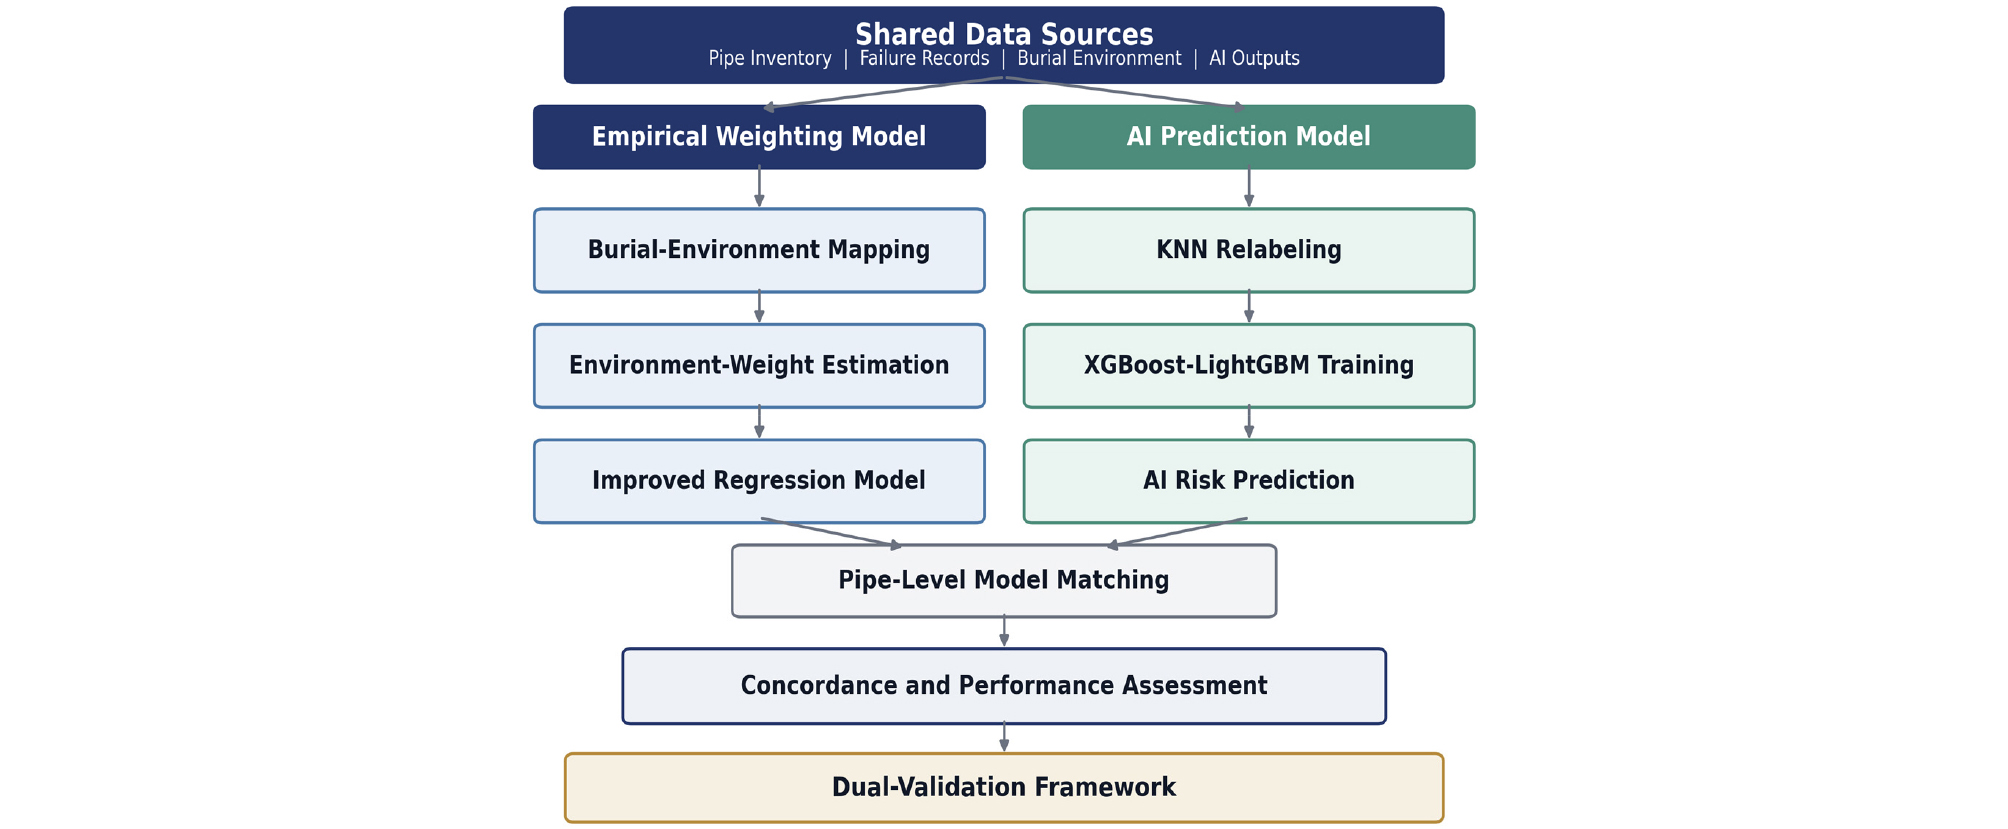
회귀모델과 AI 모델의 일치도 비교·분석을 위해 조사대상 전체 열수송관(설비이력)의 위험 순위와 고위험군 분류 결과, 실제 파손사례에 대한 판별력을 분석하였다. 먼저 전체 열수송관을 대상으로 두 모델간 위험도 점수에 대한 Spearman 순위상관계수를 산정하여 위험 순위의 일치 정도를 확인하였다. 고위험군은 각 모델에서 산정한 기본단위별 위험도 점수를 기준으로 위험도 상위 10 %, 20 %, 30 %로 구분하고, 분류 결과에 대한 Cohen’s Kappa 계수를 산정하였다. Kappa 계수는 Landis&Koch(1977)가 제시한 기준인 0.21~0.40(다소 낮음), 0.41~0.60(보통), 0.61~0.80(상당히 높음)에 따라 모델간 비교 결과를 해석하였다. 각 모델의 실제 판별력은 파손사례 2,310건을 대상으로 각 모델별 위험도 점수를 전체 열수송관 기준 백분위(percentile rank)로 변환한 후, 파손사례가 위치한 구간과 비교하여 확인하였다. 평가지표로는 평균 위험백분위, 저위험군(위험도 점수 기준 하위 50 %)으로 구분된 파손 비율, 고위험군(위험도 점수 기준 상위 10 %, 20 %, 30 %)의 실제 파손 포착률(capture rate)을 적용하였다. 가중치 산정과 검증에 동일한 파손이력을 사용하는 데 따른 과적합 여부는, 같은 루프의 파손이 학습과 검증에 동시에 포함되지 않도록 루프를 무작위로 5개 fold로 나누는 루프 단위 5-fold 교차검증과, 2009~2019년 파손으로 가중치를 산정하고 2020~2024년 파손으로 검증하는 시간 분할 검증으로 확인하였다. 데이터 수집부터 일치도 분석까지의 전체 절차는 Fig. 1과 같다.
3. 연구결과
3.1 매설환경 반영 개선모델의 성능
매설환경 가중치를 반영한 개선모델을 실제 파손이력 2,310건을 기준으로 검증하였다. 우선, 매설환경별 단순비율 가중치는 수계 7.765, 기타 1.098, 도로 0.846으로 산출되었다. 다만 수계 구간은 3,148건(전체의 1.0 %, 연장 56.6 km)으로 다른 매설환경 구간에 비해 표본이 매우 적어, 루프 단위 부트스트랩으로 산정한 수계 가중치의 95 % 신뢰구간은 6.11~9.69로 넓게 나타났다. 따라서 수계 가중치(7.765)는 본 연구 대상 관망에서 수계 구간의 상대적 위험이 높다는 방향성을 나타내는 값으로 해석해야 하며, 타 사업자·지역에 일반화하기 위해서는 추가 데이터를 통한 검증이 필요하다.
수계 구간의 파손 위험이 높은 것은 부식 가능성과 연계하여 추정 가능하다. 하천변을 포함한 하천 인접부는 지하수위가 높고 주기적으로 침수되므로, 이중보온관의 외피나 접합부 결함을 통해 보온재에 수분이 침투하기 쉽다. 이때 수분이 포함된 보온재는 단열성능이 저하될 뿐만 아니라 강관 외면의 부식을 촉진할 수 있다. 또한, 하천 퇴적층은 연약하고 함수비가 높아 지반 침하와 부등변위가 발생하기 쉽고, 교량 하부나 제방 횡단부에서는 열팽창과 구조물 접속부의 구속으로 응력이 집중되어 파손 위험이 증가할 수 있다. 시설물 점검 측면에서는 수계구간의 경우 접근성이 낮아 초기 결함의 발견이 늦어질 수 있다. 실제로 수계 파손 206건의 현장상태는 지열(100건)과 누수(34건)가 대부분을 차지했다.
실제 파손이력이 저위험군(하위 50 %)으로 구분되는 오분류 비율은 기존 45.3 %에서 42.5 %로 2.8 % 개선되었다(Table 1 참고). 수계구간의 경우 오분류 비율이 43.2 %에서 22.3 %로 20.9 % 낮아져 매설환경 가중치의 영향이 가장 크게 나타났다. 이는 수계 가중치가 다른 매설환경에 비해 매우 크기 때문에 가중치 반영으로 수계 구간에 해당하는 열수송관의 위험도 점수가 크게 증가했기 때문으로 해석할 수 있다.
Table 1의 결과는 모델의 가중치 산정과 검증을 위해 동일한 파손이력을 사용한 In-sample 결과이다. 루프 단위 5-fold 교차검증에서 fold별 수계 가중치는 7.22~8.38이었으며, 저위험군 오분류율 개선폭은 In-sample 대비 약 90 %가 유지되어 가중치의 과적합은 크지 않은 것으로 나타났다. 반면 2009~2019년 파손(1,792건)으로 가중치를 산정하고 2020~2024년 파손(518건)으로 검증한 시간 분할 검증에서는 전체 오분류율 개선폭이 0.6 %p로 매우 작았다. 이는 검증기간의 수계 파손이 17건에 불과하여 검증 자료 대부분이 가중치의 영향을 받지 않았기 때문이며, 이 17건에서는 저위험군 오분류율이 17.6 %p 낮아지는 것을 확인하였다. 이를 통해 매설환경 가중치의 개선 효과는 전체 관망보다 수계 구간에 집중되어 나타나는 것으로 판단하였다.
Table 1.
Reduction in low-risk misclassification after applying burial-environment weights
| Category |
Low-risk misclassification (before weighting) |
Low-risk misclassification (after weighting) | Change |
| All pipeline segments | 45.3% | 42.5% | -2.8% |
| Waterway segments | 43.2% | 22.3% | -20.9% |
3.2 전체 열수송관 모집단 기준 AI-개선모델 순위 일치도
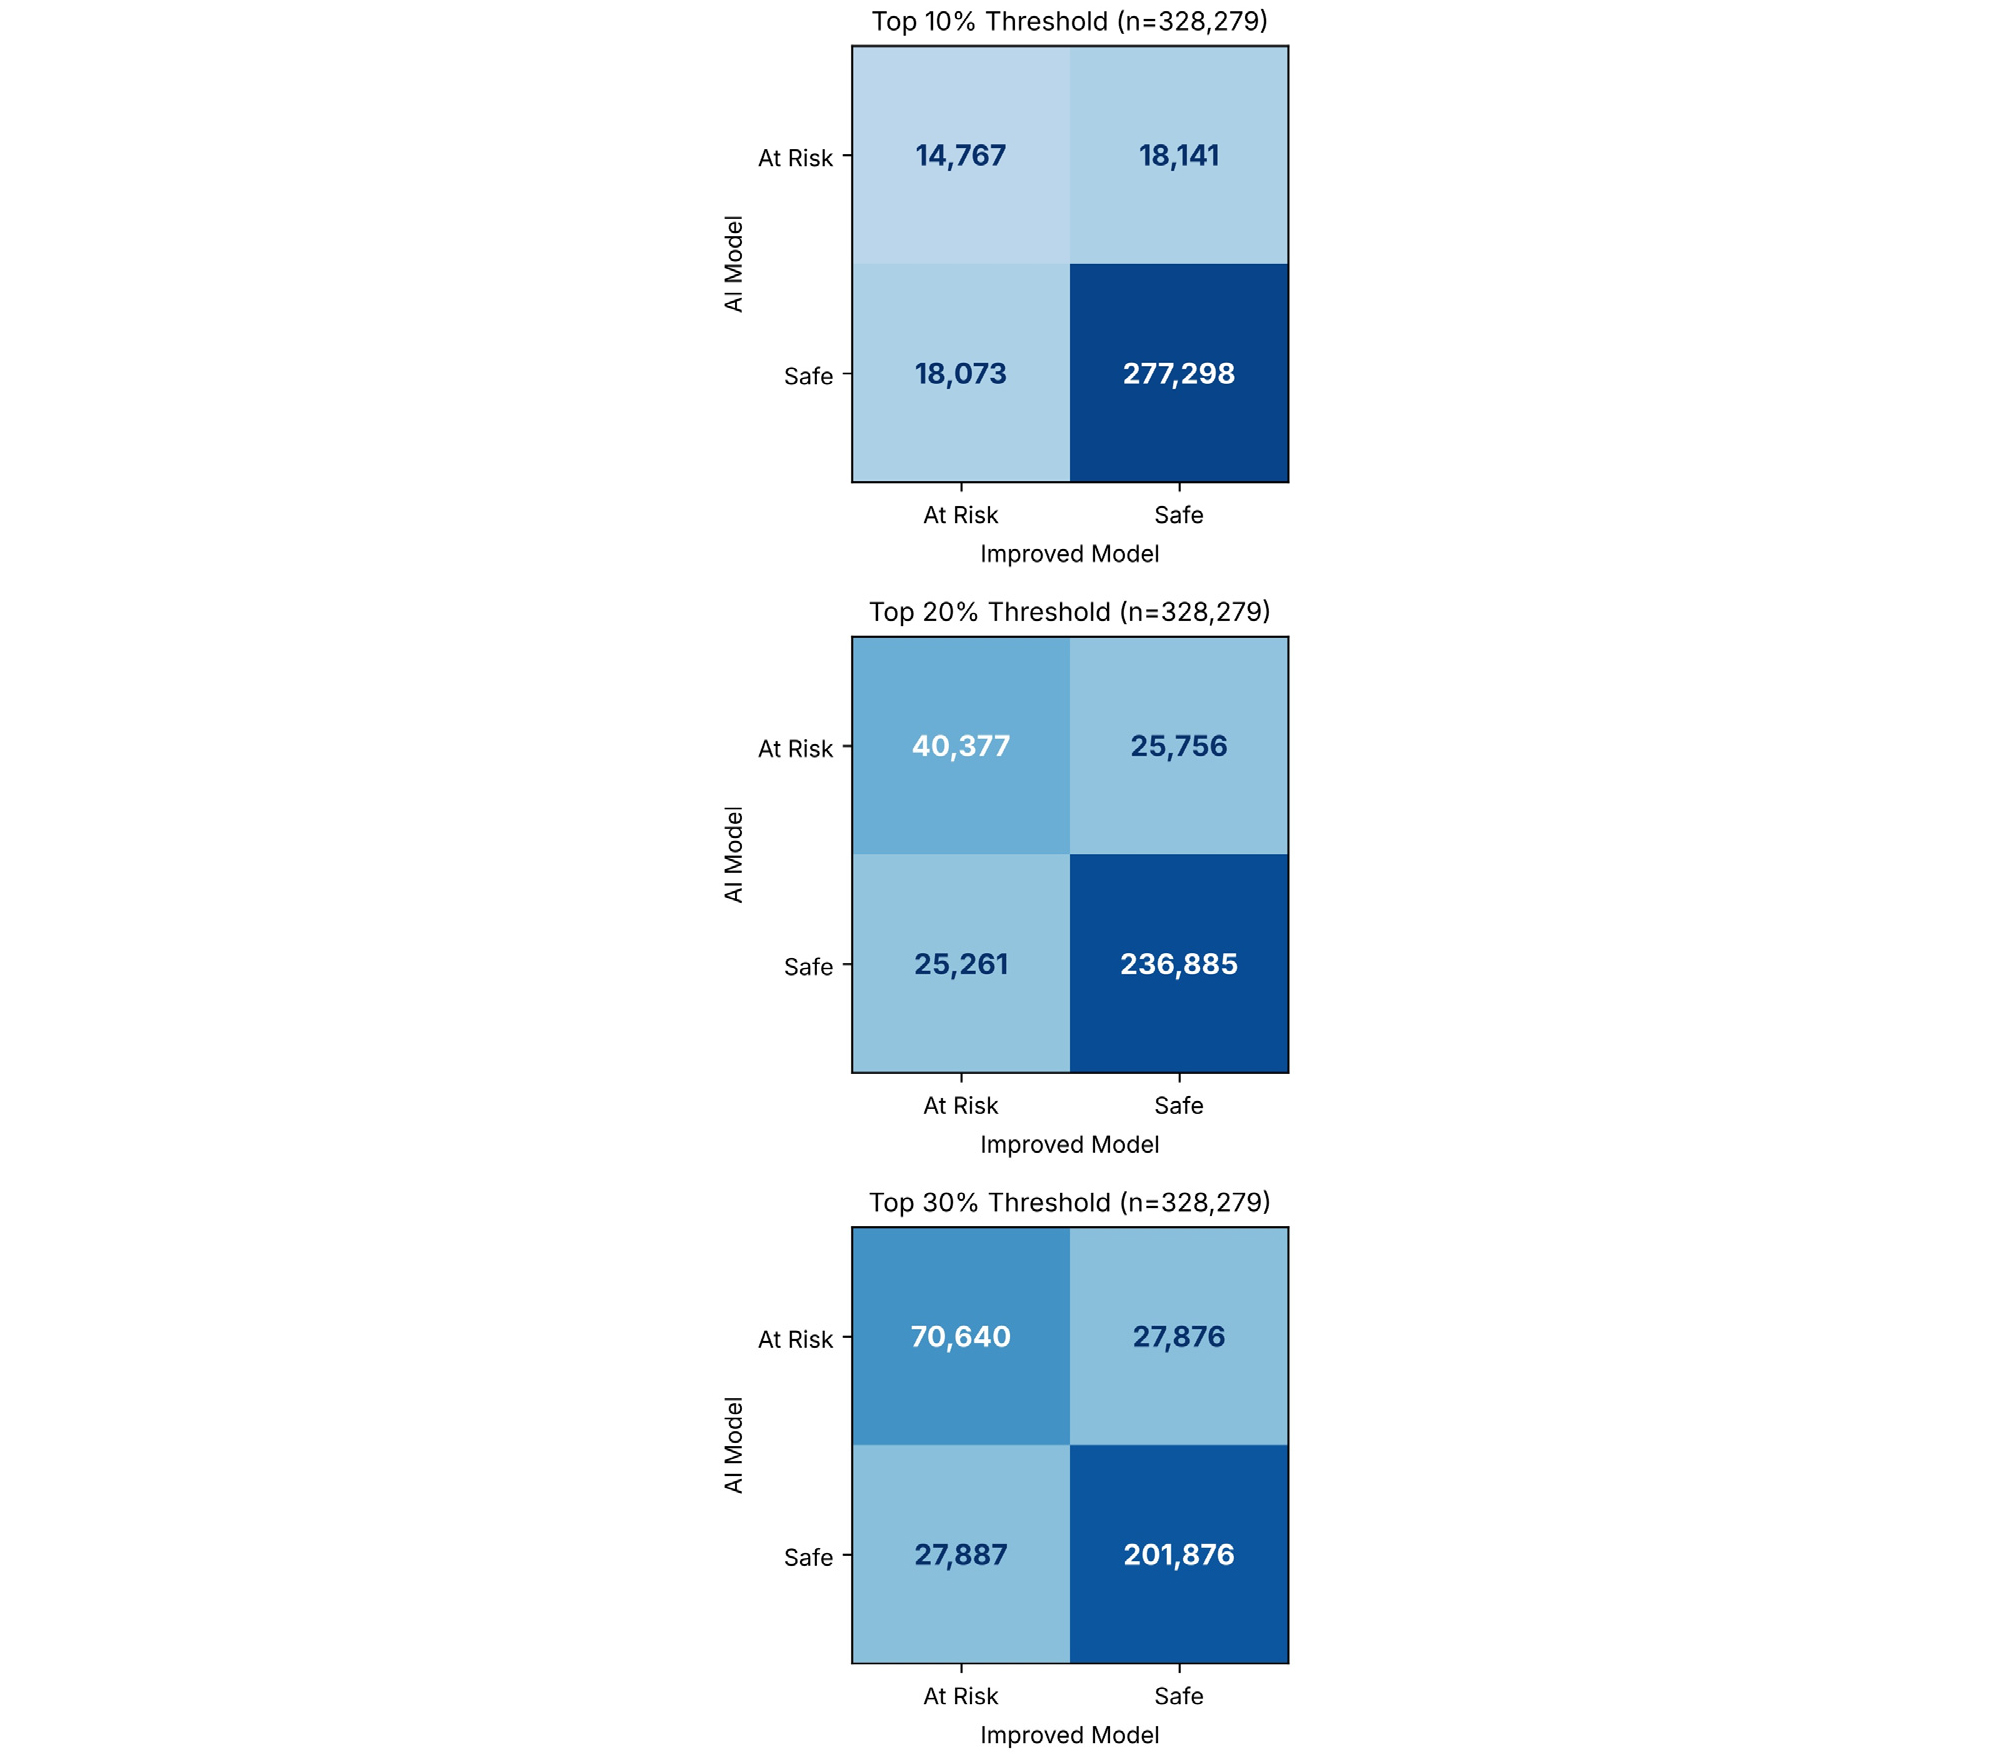
전체 열수송관 설비이력 328,279건을 대상으로 회귀분석 개선모델과 AI 모델의 위험도 점수를 비교한 결과, Spearman 순위상관계수는 0.695로 두 모델이 중간 이상 수준의 위험 순위 일치도를 보였다(p<0.001). 반면 기존 회귀분석 모델과 AI 모델의 순위상관계수는 0.687로(p<0.001), 회귀분석 모델 개선을 통해 AI 모델과의 일치도가 상승한 것으로 판단할 수 있다. Table 2와 같이 고위험군 분류에 대한 Kappa 계수는 상위 10 %에서 0.388, 상위 20 %에서 0.516, 상위 30 %에서 0.596으로 산정되었으며, 모든 결과가 통계적으로 유의함을 확인하였다(p<0.001). 또한 Fig. 2와 같이 고위험군의 범위를 넓힐수록 일치도가 증가한 것으로 볼 때, 두 모델의 전반적인 위험 순위는 유사하지만 최상위 고위험 열수송관을 선정한 결과에 차이가 있는 것으로 판단된다. Landis&Koch(1977)의 기준을 적용하면 0.39~0.60의 Kappa 값은 ‘다소 낮음’에서 ‘보통’ 수준에 해당하므로 상호간 독립적으로 개발된 두 모델의 열수송관 위험도 판단 결과가 우연 수준보다는 높게 일치하는 것을 확인할 수 있다.
Table 2.
Agreement between the improved and AI models in classifying high-risk segments (Cohen’s kappa; n=328,279)
| High-risk threshold | Both models | AI model only | Improved model only | Kappa |
| Top 10% | 14,767 | 18,073 | 18,141 | 0.388 |
| Top 20% | 40,377 | 25,261 | 25,756 | 0.516 |
| Top 30% | 70,640 | 27,887 | 27,876 | 0.596 |
두 모델의 열수송관 위험순위 판단결과 일치 여부는 사업자가 유지관리 대상의 성능개선 우선순위를 정하는 데 활용할 수 있다. 두 모델에서 모두 고위험군으로 구분된 열수송관은 성능개선 우선순위를 높게 설정하고, 한 모델에서만 고위험군으로 구분된 열수송관은 안전진단 등 현장조사를 통해 위험 여부를 추가로 확인하는 등 의사결정 체계를 보다 정밀하게 설계할 수 있다.
3.3 실제 파손사례 기준 3자 비교
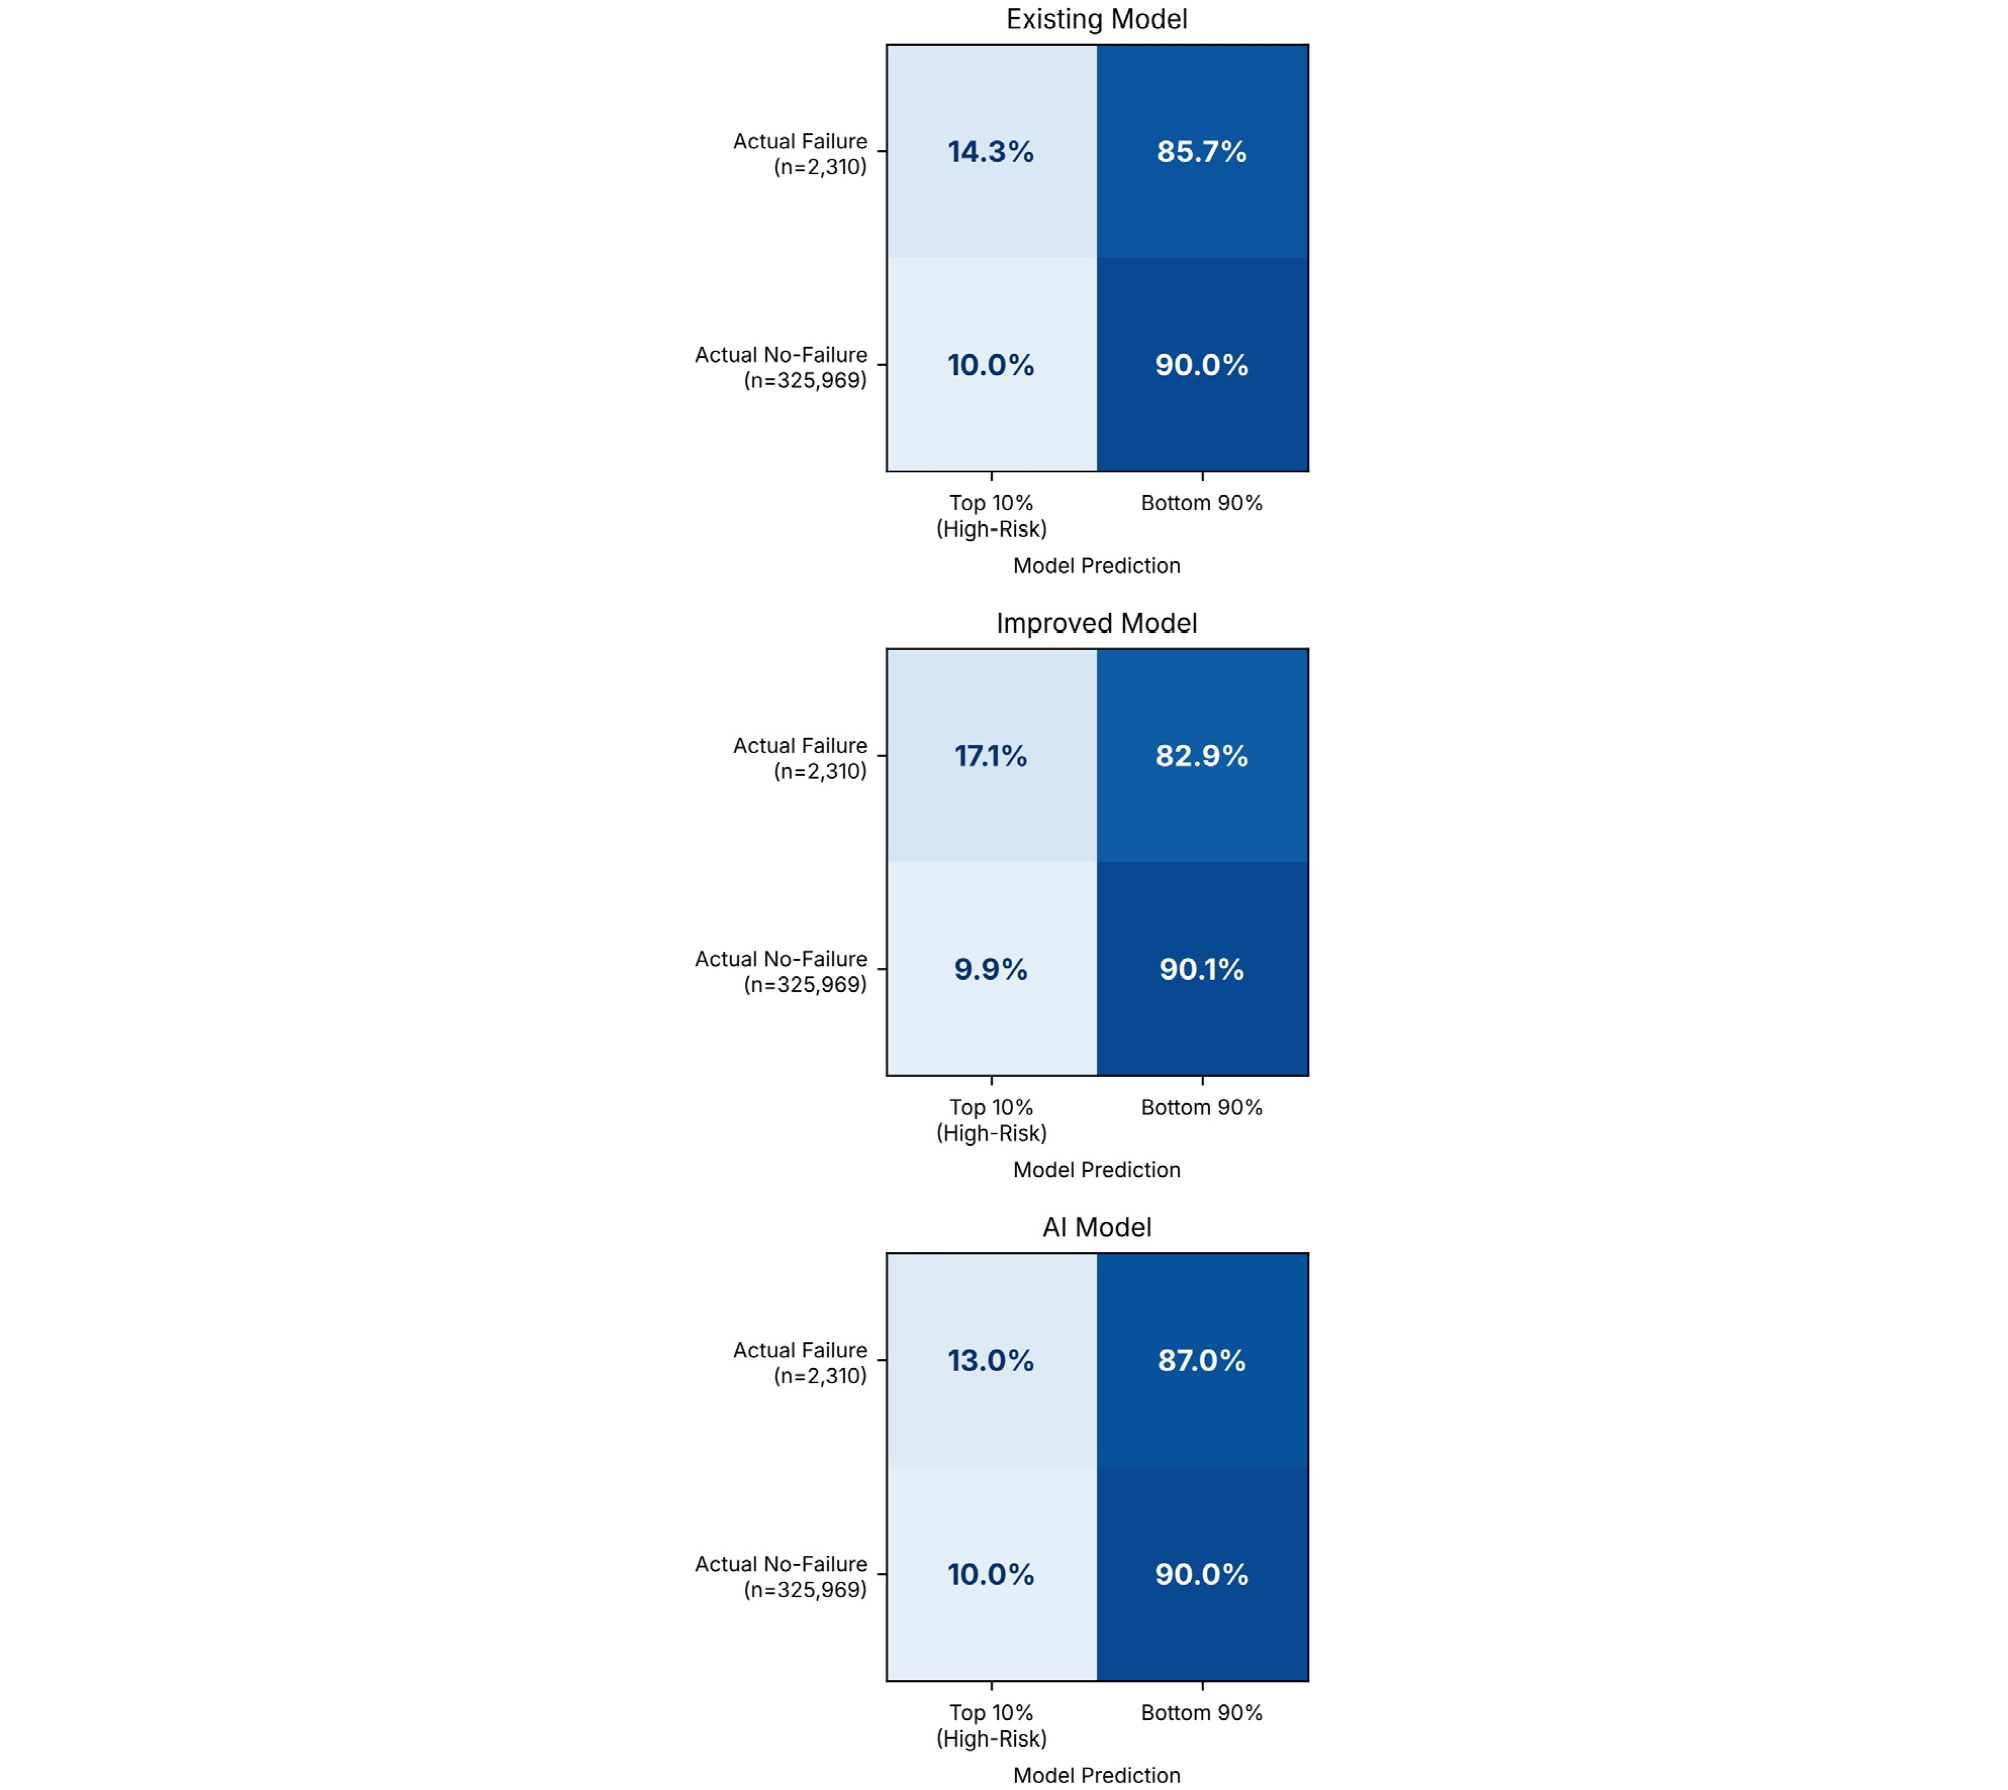
실제 파손사례 2,310건을 기준으로 기존 회귀모델, 개선된 회귀모델 및 AI 모델의 판별 성능을 비교한 결과는 Table 3과 같다. 비교 결과, AI 모델은 평균 위험백분위 59.3, 저위험군 오분류 비율 36.5 %, 위험도 상위 20 % 및 30 % 포착률 28.7 %와 43.1 %로 두 회귀분석 모델보다 우수한 결과를 나타내었다. 다만 위험도 상위 10 % 포착률은 개선된 회귀모델이 17.1 %로 AI 모델의 13.0 % 보다 높게 나타나, AI 모델의 판별 성능이 모든 위험구간에서 우수한 것은 아님을 확인하였다(Fig. 3 참조). 이를 통해 현장에서 위험도를 고려하지 않고 특정 구역(지자체 등) 내 전체 열수송관을 대상으로 성능개선 우선순위를 결정할 경우 AI 모델의 판단 결과를 신뢰하는 것이 바람직하다고 판단할 수 있다. 반면 고위험군만을 대상으로 성능개선 물량을 선별할 때는 오히려 회귀분석 모델이 장점을 가지는 것으로 볼수 있다. 다만 AI 모델의 위험확률 역시 동일한 파손이력으로 학습된 모델의 출력이므로, Table 3에 확인 가능한 비교 조건은 세 모델 모두 In-sample 조건에서의 상대 비교이다.
Table 3.
Discriminative performance of the three models for observed failure cases (n=2,310)
위험도에 따른 실제파손 포착률은 Fig. 4의 누적이득곡선을 통해서도 확인 가능하다. 누적이득곡선은 위험도 누적 비율에 따라 실제 파손사례의 포착 수준을 나타내는 것으로, 모든 모델이 무작위 기대선(Random expectation) 보다 실제 파손 포착률이 우수한 것으로 나타났다. 특히 AI 모델의 파손 포착률이 고위험 구간(위험도 상위 10 % 이내)을 제외하면 대부분 우수한 것을 확인할 수 있다.
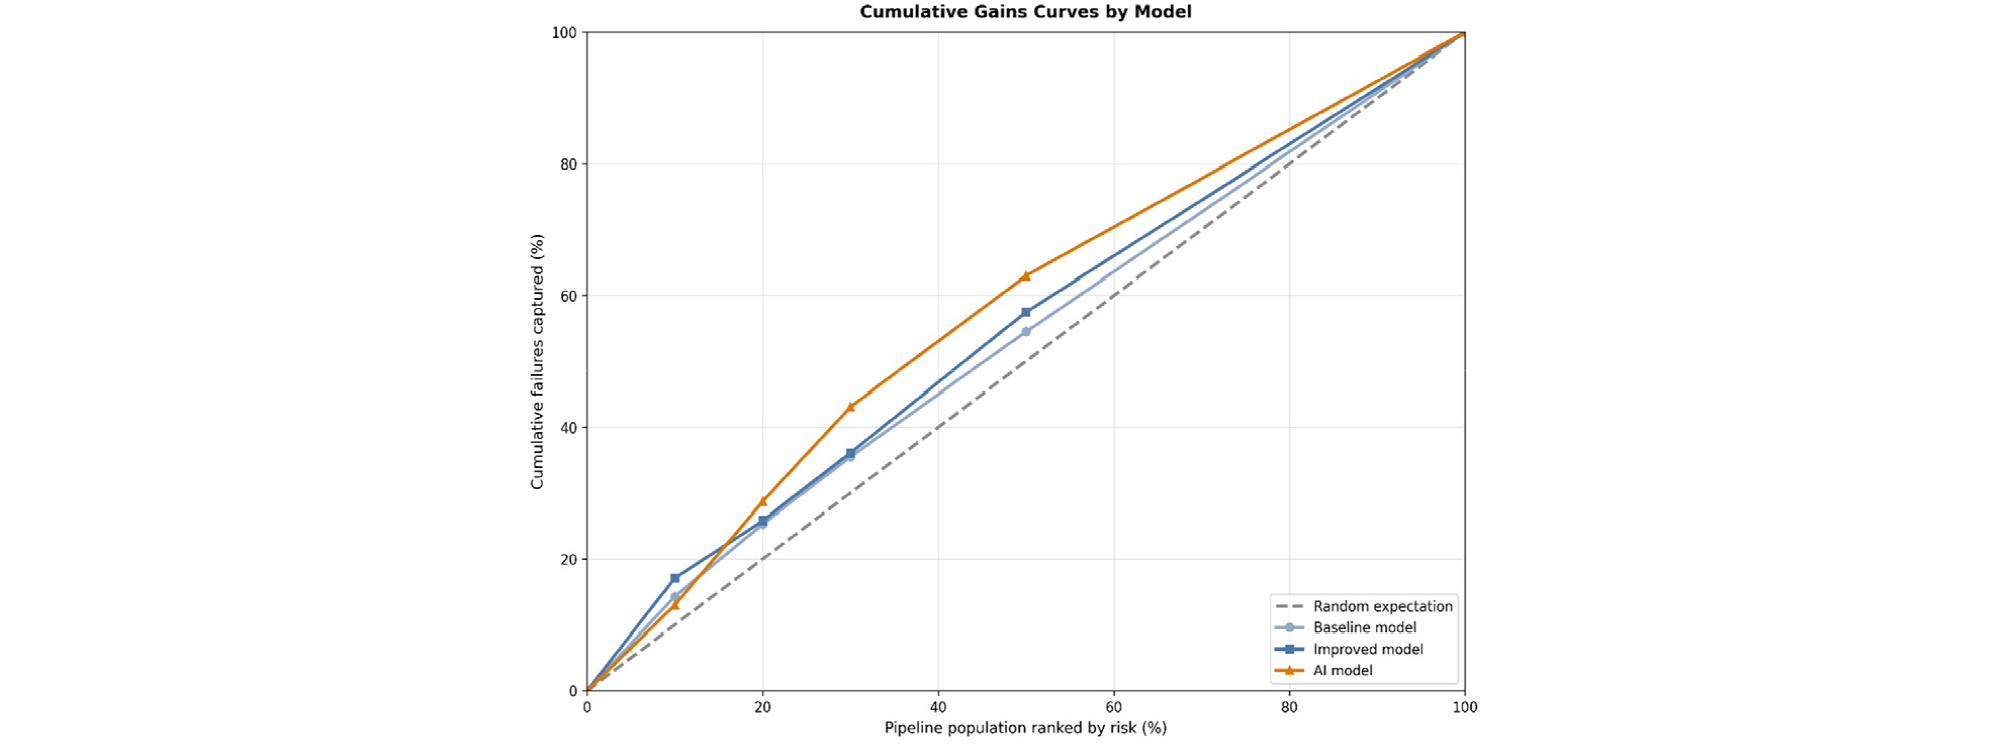
개선된 회귀모델과 AI 모델의 성능 차이는 모델 구조에 따른 것으로 판단된다. 개선된 회귀모델은 사용기간을 독립변수로 하는 지수형 회귀식에 기반을 두고 있으므로 열수송관의 사용기간이 길어질수록 파손확률이 높게 산출되며, 최상위 위험군 판별에 상대적으로 유리하다. 반면 AI 모델은 여러 변수의 비선형적 상호작용을 학습하므로 사용기간만으로 설명하기 어려운 중간 수준의 위험 열수송관을 비교적 폭넓게 선별할 수 있는 것으로 판단된다.
이러한 해석 결과는 AI 모델의 변수 기여도로도 확인된다. 대리모델은 검증 자료에서 AI 모델의 위험확률을 R2=0.999로 재현하였으며, SHAP 기여도는 사용기간 48.5 %, 절연레벨 24.3 %, 매설환경(기타) 10.4 %, 관경 9.4 %, 용도 7.1 %, 매설환경(수계) 0.4 % 순으로 나타났다(Table 4). 이를 통해 AI 모델도 사용기간을 가장 중요하게 학습하였으나 기여도는 절반 수준이며, 나머지 절반은 절연레벨, 관경, 용도가 설명하는 것을 알 수 있다. 또한 AI 모델은 수계 환경에 별도의 위험 증가를 부여하지 않아, 수계 가중치가 두 모델의 최상위 고위험군 차이에 기여한 것으로 판단된다.
Table 4.
Feature contributions of the AI model estimated by the surrogate model (SHAP)
3.4 이중검증 체계의 현장 적용 방안
개선된 회귀모델과 AI 모델의 판정결과가 서로 다른 구간의 실제 위험 수준을 확인하기 위해, 파손이력(2009~2024년)을 이용하여 판정 조합별 기본단위 1,000건당 파손 건수(파손밀도)를 사후 검토하였다. 분석 결과, 위험도 상위 10 % 기준에서는 한 모델에서만 고위험으로 판정된 구간도 두 모델 모두 고위험으로 판정한 구간과 비슷한 파손밀도(11.7~12.6건)를 보였으며, 이는 양쪽 모두 저위험인 구간(6.1건)의 약 2배 수준이었다. 상위 20 % 기준에서는 AI 모델만 고위험으로 판정한 구간(12.2건)은 높은 파손밀도를 유지했으나, 개선된 회귀모델만 고위험으로 판정한 구간(6.5건)은 저위험 구간(5.7건)과 비슷하였다. 또한 두 모델 백분위의 단순평균으로 만든 통합 점수는 상위 10 % 포착률이 AI 모델과 비슷하며, 상위 30 % 포착률은 AI 모델보다 낮아 단순 결합의 이점은 없었다.
위의 분석결과를 토대로 Table 5와 같은 단계별 점검 우선순위를 제시하였다. 우선 동일 우선순위 내에서는 두 모델 백분위 중 높은 값 순으로 정렬한다. 예를 들어 특정 구역에서 매년 10 %의 열수송관을 성능개선 대상으로 검토하는 경우, 먼저 두 모델이 모두 상위 20 %로 판정한 구간을 1순위 성능개선 후보로 선정한 후, 어느 한 모델이라도 상위 10 %로 판정한 구간은 안전진단 대상에 포함하며, AI 모델만 상위 10~30 %로 판정한 구간은 감시시스템 점검 주기를 단축할 수 있다. 이를 통해 한정된 예산을 활용하여 효율적으로 성능개선 대상을 선정하거나 유지관리 지침을 수립할 수 있다. 다만 위의 예시는 과거 파손이력에 근거한 것으로 안전진단 등 현장조사 결과를 통해 검증되어야 한다.
Table 5.
Stepwise inspection priority based on the agreement between the two models
4. 결 론
본 연구에서는 열수송관 기본단위별 매설환경 속성을 재구축하고 이를 반영하여 개선된 회귀분석 모델을 구축하였다. 또한 실제 파손사례를 활용하여 개선 전후 회귀모델과 AI 기반 예측모델간 판별력과 일치도를 비교·분석하였으며, 주요 결론은 다음과 같다.
(1) 매설환경 가중치를 반영하여 개선된 회귀모델은 기존 회귀모델 대비 저위험군의 오분류 비율이 45.3 %에서 42.5 %로 개선되었으며, 특히 수계구간에서는 43.2 %에서 22.3 %로 크게 개선되었다. 또한 루프 단위 교차검증에서도 개선폭이 약 90 %로 유지되었다.
(2) 개선된 회귀모델과 AI 모델은 전체 분석대상 열수송관 기본단위를 기준으로 중간 수준의 순위 일치도(Spearman ρ=0.695)를 보였다. 다만 고위험군 분류의 일치도는 ‘다소낮음’에서 ‘보통’ 수준(Kappa 0.39~0.60)으로 확인되었으며, 특히 위험도 최상위 구간에서는 두 모델이 고위험군으로 선정한 열수송관이 일부 다르게 나타났다.
(3) AI 모델은 실제 파손사례에 대한 전반적인 판별력 이 개선 전후 회귀모델 보다 우수하였다. 다만, 위험도가 가장 높은 상위 10 % 고위험 열수송관의 포착성능은 오히려 회귀모델이 더 우수한 것으로 나타났다. 따라서 두 모델이 열수송관의 위험수준에 따라 정확하게 판별 가능한 범위가 서로 다른 것을 확인하였다.
본 연구를 통해 매설환경 가중치 개선 회귀모델과 AI 예측모델의 장단점을 확인하였으며, 두 모델을 열수송관 위험수준에 따라 선택적으로 활용하는 이중검증(dual-validation) 체계를 구축할 경우, 열수송관 위험도 평가체계의 신뢰성을 높이는 데 기여할 수 있을 것으로 판단된다. 다만 수계 구간은 전체 열수송관의 1.0 %에 불과하고 수계 가중치의 95 % 신뢰구간이 6.11~9.69로 넓기 때문에 설비이력과 파손이력의 수계 분류 기준이 다르다는 한계가 있다. 또한 두 모델의 위험 판정 결과가 서로 다른 구간에 대해서 안전진단 등 현장확인 결과는 확보하지 못하였다. 향후 수계구간의 정의와 범위를 재설정하고, 토질·지하수위 등 세부 지반조건을 반영하여 가중치의 안정성을 검증하고, 안전진단 결과를 활용하여 이중검증 체계를 보완할 필요가 있다.